Abstract:
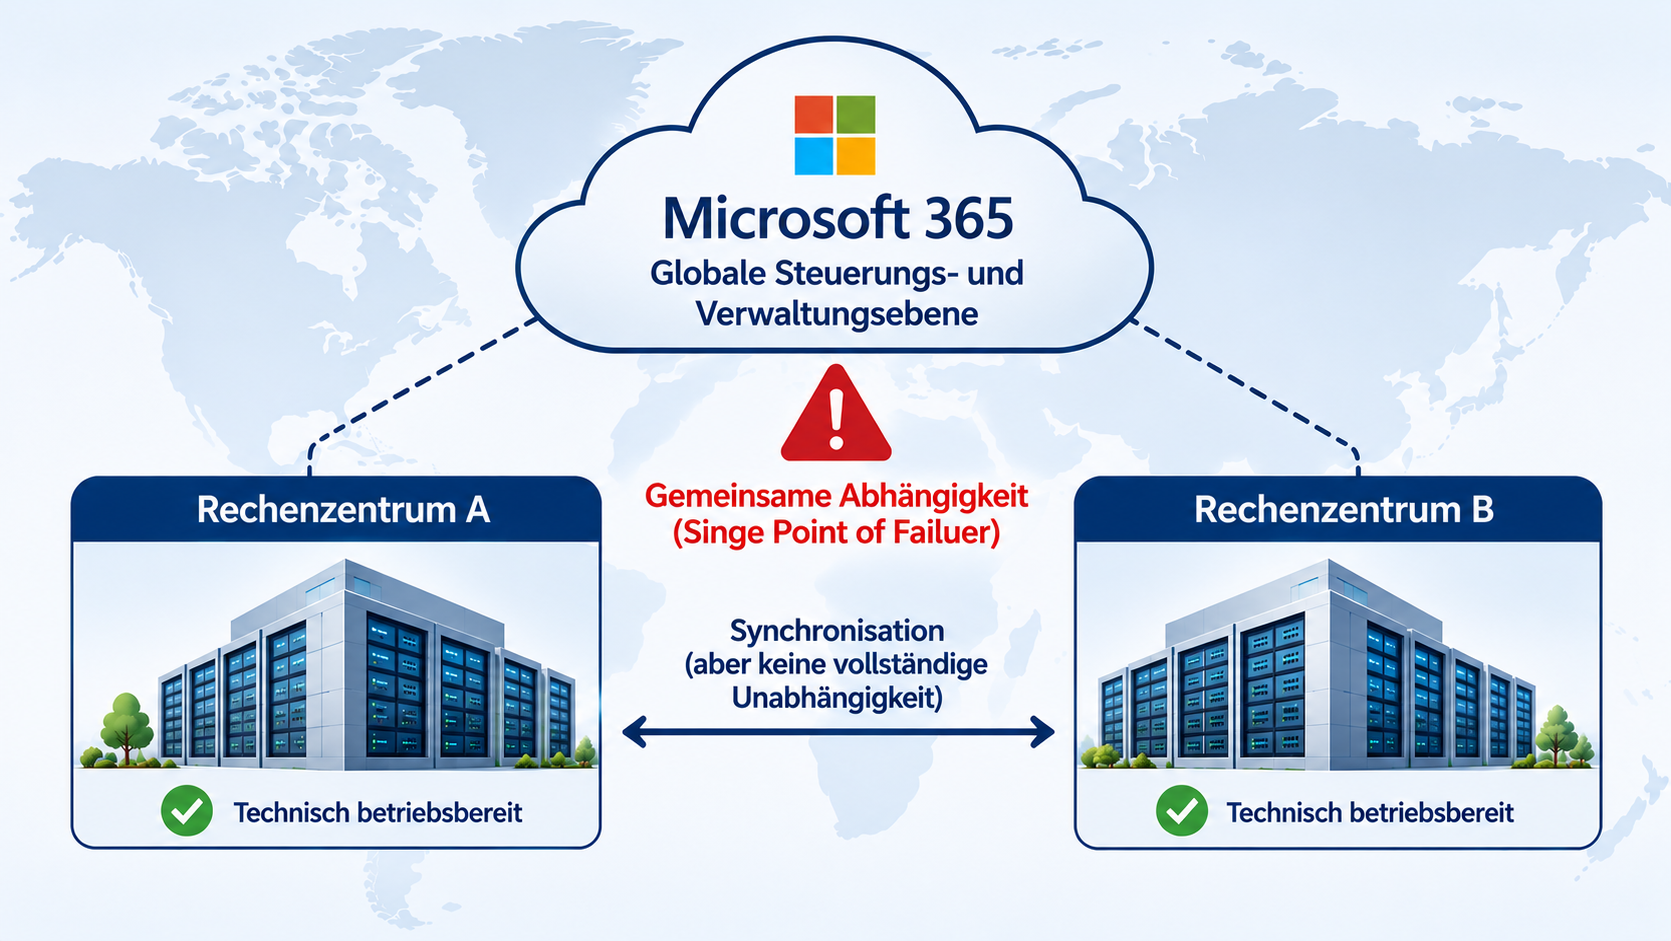
Europäische Rechenzentren und Initiativen wie die EU Data Boundary gewährleisten zwar die DSGVO-konforme Datenhaltung innerhalb der EU, bieten jedoch noch keine technische Betriebsunabhängigkeit. Jüngste Störungen bei Microsoft 365 zeigen: Solange europäische Cloud-Regionen von globalen Steuerungs- und Identitätsdiensten (Control Plane) wie Microsoft Entra ID abhängen, bleiben überregionale Ausfälle ein strukturelles Risiko. Echte digitale Resilienz erfordert neben der Datenlokalisierung auch eine architektonische Entkopplung der Steuerungsebene.
Was die jüngsten Outlook- und Microsoft-365-Störungen über die Hochverfügbarkeit globaler Cloud-Dienste verraten.
Die jüngsten Störungen bei Microsoft 365 und Outlook werfen eine grundsätzliche Frage auf: Wie unabhängig sind die europäischen Rechenzentren von Microsoft tatsächlich, wenn zentrale Komponenten der globalen Cloud-Infrastruktur ausfallen?
Microsoft betreibt eigene Rechenzentren in Europa. Für europäische Kunden können E-Mails, Dokumente und andere Unternehmensdaten innerhalb der Europäischen Union gespeichert und verarbeitet werden. Auch die EU Data Boundary soll sicherstellen, dass bestimmte Kundendaten innerhalb Europas verbleiben.
Das ist aus Datenschutzsicht wichtig. Mit einer vollständig unabhängigen europäischen IT-Infrastruktur ist dies allerdings nicht gleichzusetzen.
Ein Europäischer Datenstandort ist nicht gleich Betriebsunabhängigkeit
Moderne Cloud-Dienste bestehen aus weit mehr als den eigentlichen Servern und Speichersystemen. Authentifizierung, Identitätsverwaltung, Verzeichnisdienste, Netzwerksteuerung, Konfigurationsmanagement und zahlreiche weitere Komponenten sind für den reibungslosen Betrieb erforderlich.
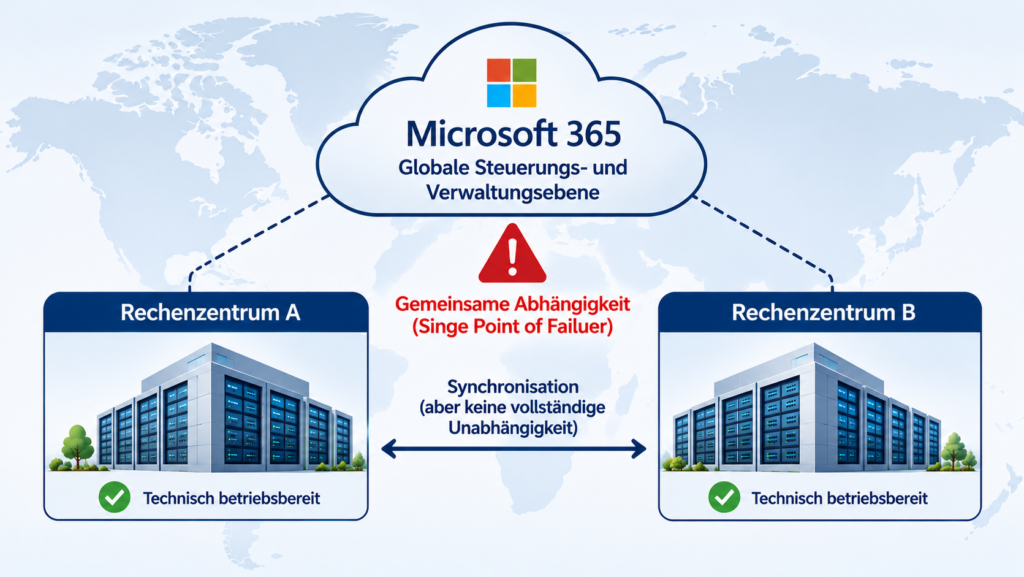
Ein europäisches Exchange-Postfach kann deshalb durchaus auf einem europäischen Server liegen und trotzdem von globalen Microsoft-Diensten abhängig sein.
Fällt eine solche zentrale Komponente aus, kann ein regionales Rechenzentrum weiterhin technisch intakt sein, während die Kunden ihre Dienste nicht mehr oder nur eingeschränkt nutzen können.
Die geografische Verteilung der Hardware garantiert somit noch keine technische Unabhängigkeit.
Redundanz muss auch die Steuerungsebene umfassen
In der klassischen Rechenzentrumsplanung gehört es zum Grundverständnis einer Hochverfügbarkeitsarchitektur, dass zwei geografisch getrennte Standorte möglichst unabhängig voneinander betrieben werden können.
Dazu gehören nicht nur redundante Server, Storage-Systeme und Netzwerkverbindungen. Auch zentrale Steuerungs- und Authentifizierungsdienste müssen entsprechend abgesichert sein.
Ein gemeinsamer Dienst, dessen Ausfall beide Rechenzentren gleichzeitig beeinträchtigt, stellt einen potenziellen Single Point of Failure dar.
Eine solche Architektur kann zwar eine hohe lokale Verfügbarkeit bieten, ist aber gegenüber bestimmten übergreifenden Störungen nicht ausreichend isoliert.
Wie müsste eine wirklich redundante Infrastruktur aussehen?
Eine konsequent auf Hochverfügbarkeit ausgelegte Architektur würde zwei eigenständig funktionsfähige Rechenzentrumsstandorte vorsehen.
Beide Standorte sollten über eigene Steuerungs-, Authentifizierungs- und Betriebsmechanismen verfügen. Die Synchronisation der Daten und die gegenseitige Überwachung wären weiterhin sinnvoll, dürften aber keine zwingende Voraussetzung für den laufenden Betrieb sein.
Auch Updates und Konfigurationsänderungen müssten so umgesetzt werden, dass ein Fehler nicht gleichzeitig beide Standorte beeinträchtigen kann.
Das Ziel wäre eine Infrastruktur, bei der ein vollständiger Ausfall eines Standorts oder zentraler Dienste außerhalb der eigenen Region nicht automatisch zum Ausfall der verbleibenden Infrastruktur führt.
Eine offene Frage an Microsoft
Die aktuellen Störungen belegen nicht, dass ein Ausfall amerikanischer Rechenzentren unmittelbar für die Probleme in Europa verantwortlich war. Die genaue technische Ursache und die konkreten Abhängigkeiten müssen differenziert betrachtet werden.
Sie verdeutlichen aber ein grundsätzliches Problem global organisierter Cloud-Plattformen: Zentrale Verwaltungs- und Steuerungsstrukturen können selbst zu kritischen Fehlerdomänen werden.
Für Unternehmenskunden sollte deshalb nicht allein entscheidend sein, wo ihre Daten gespeichert werden. Ebenso wichtig ist die Frage, wie unabhängig die jeweilige regionale Infrastruktur tatsächlich arbeiten kann.
Das Internet als Vorbild: Dezentralisierung statt zentraler Abhängigkeiten
Ein Blick auf die Architektur des Internets zeigt, dass es auch anders geht. Das Internet wurde von Grund auf als verteiltes Netzwerk konzipiert. Ein wesentliches Element sind beispielsweise die weltweit verteilten DNS-Systeme. Durch redundante Nameserver, geografisch getrennte Infrastruktur und dezentrale Zuständigkeiten bleibt die Namensauflösung auch dann funktionsfähig, wenn einzelne Systeme oder ganze Regionen ausfallen.
Natürlich lässt sich dieses Prinzip nicht vollständig auf komplexe Cloud-Plattformen wie Microsoft 365 übertragen. Identitätsverwaltung, Datenkonsistenz und zentrale Sicherheitsmechanismen stellen ganz andere Anforderungen. Dennoch ist die grundsätzliche Idee übertragbar: Kritische Funktionen sollten möglichst dezentral organisiert und so voneinander entkoppelt werden, dass der Ausfall einzelner Komponenten nicht zum Ausfall einer gesamten Plattform führt.
Die Architektur des Internets zeigt seit Jahrzehnten, dass Robustheit nicht durch eine möglichst zentrale Kontrolle entsteht, sondern durch intelligente Verteilung, Redundanz und Unabhängigkeit. Genau diese Prinzipien sollten auch bei der Weiterentwicklung globaler Cloud-Infrastrukturen eine größere Rolle spielen.
Quellen:
Microsoft auf X